
目次
一. 设计草稿
数据通路
流水线CPU与我们之前的单周期CPU最大的不同,就是流水线要设置流水寄存器把需要用到的数据暂存起来,除此以外,我们大部分的元器件都是不需要进行大规模的修改的,因此根据老师课上PPT的这张图,我们可以较为轻松的搭出大概的数据通路,如图:
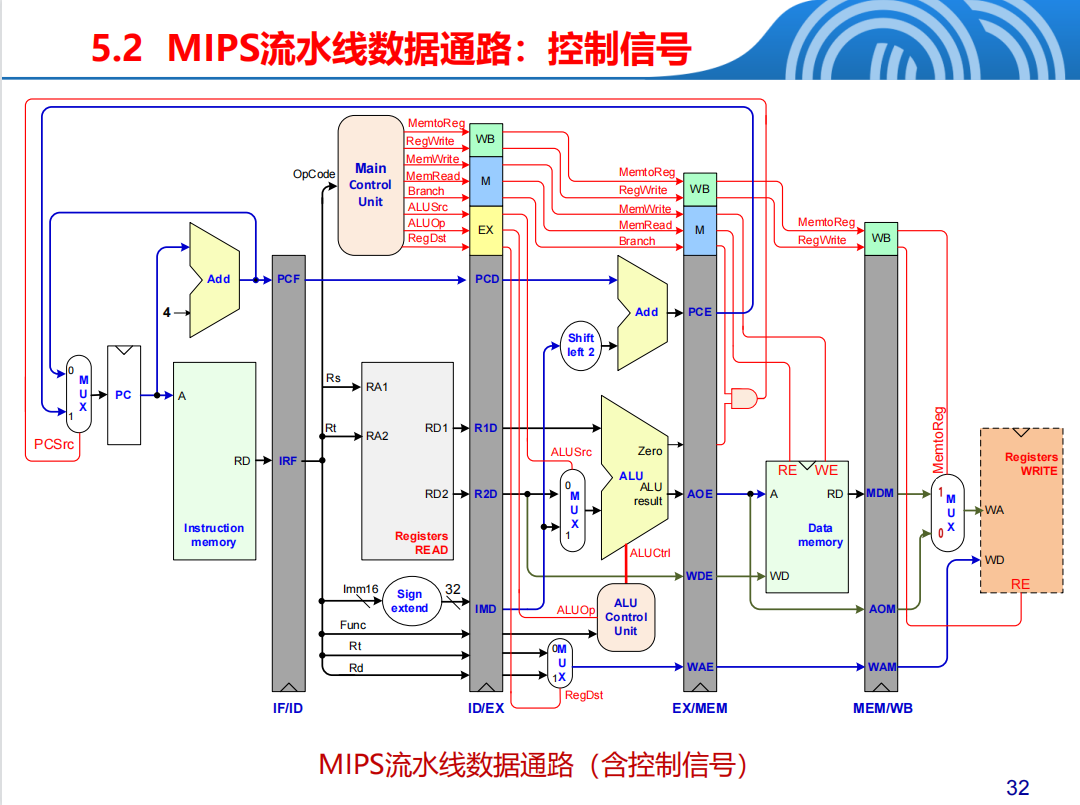
PS:虽然大部分的元器件可以复用,但是因为使用集中式译码的话流水寄存器要传递的数据实在过多,而且要区分不同级别的同名信号,因此即便是最简单的理线也耗费了我近一天的时间
至此,当我以为P5的工作已经完成大半时,殊不知真正的挑战才刚刚开始……
冒险控制
冒险种类
流水线虽然有效的提高了CPU执行指令的效率,但是却同样的带来了一个问题,即数据冒险和控制冒险
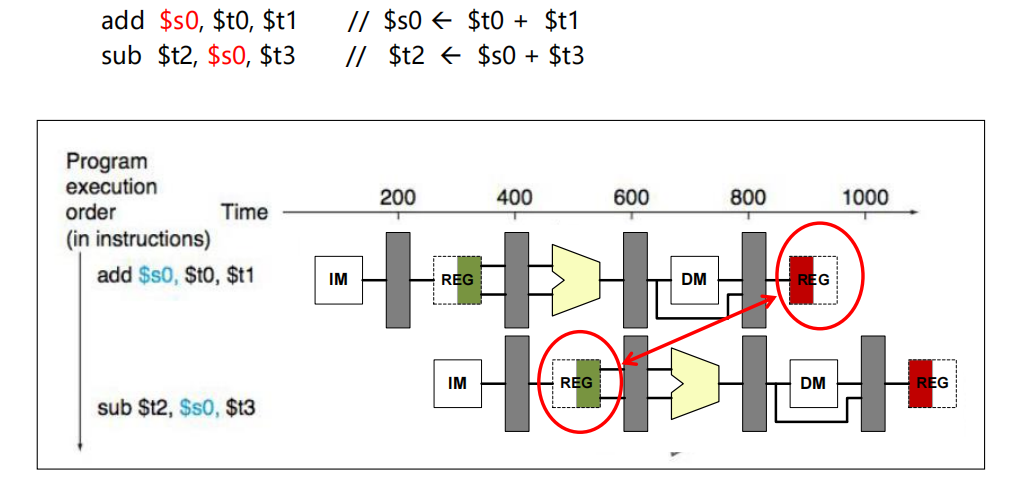
后面的指令执行需要使用前面指令的结果,此时结果尚未形成,带来数据冒险
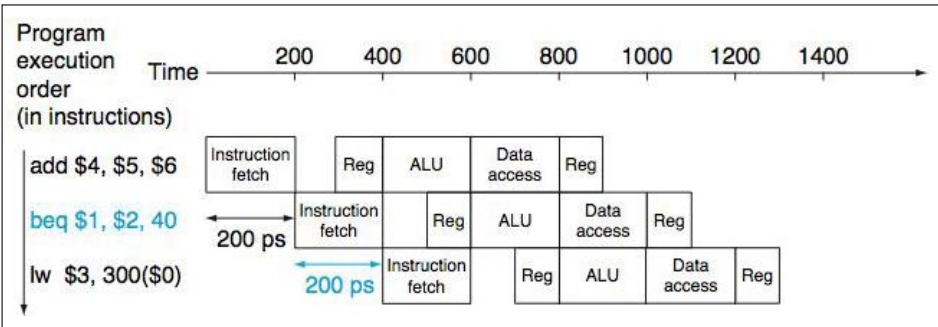
对跳转类指令,需要执行完方知道下次的PC值,此时形成结构冒险
虽然这两种冒险的形式不同,但其问题本质都是一样的,即如何提前使用“没产生”的数据 我们的策略是——转发和暂停
冒险控制思路
-
使用AT模型 当一条指令进入ID级时,就分析出这条指令可能产生的所有冒险的情况 然后把控制信号存入流水寄存器,随着流水在不同模块发挥控制作用 因此需要输入来自ID级的rs_Tuse和rt_Tuse,来自EX级的WAE和TnewE,来自MEM级的WAM和TnewM 至于WB级,因为我们的GRF使用了下降沿写入,因此可以解决同周期读写的问题,也就无需内部转发
-
Tuse和Tnew的说明
Tuse是该数据将被使用的最晚周期数Tnew是该数据产生且被写入流水寄存器所需的最少周期数TnewD,TnewE,TnewM要递减1,除非为0Tuse= 0 说明数据在ID级就需要被使用(branch和jr)Tnew= 0 说明需要的数据已经可用(位于上级的流水寄存器中) 只是还未写入寄存器Tuse<Tnew时需要暂停,pause = 1Tuse>=Tnew时要根据具体情况设计转发线路 -
取值问题
rs_Tuse < 2,rt_Tuse <= 2rt_Tuse = 2时为DM的WriteData输入 故当不需要数据时,可以将Tuse设为3TnewD <= 3,TnewE <= 2,TnewM <= 1lw指令时取等于号 -
本人设计的全部转发线路(按流水级顺序)
R1E到RD1,RD2AOM到ALUA,ALUB,RD1,RD2RWDW到ALUA,ALUB,DWD
备注:GRF使用下降沿写入,无需使用内部转发,即无需考虑同周期读写一个寄存器的情况
-
转发思路 转发尽可能的早,即数据一旦产生立即转发,不管当前是不是要用 转发的数据都来自上级的流水寄存器中,避免组合逻辑的延迟增大
为什么用这一套控制思路就可以解决以上两种冲突呢? 数据冒险还说得过去,但控制冒险的处理不应该更复杂吗?
事实上我还做了另一件事,即把跳转类指令的判断提前到了ID级 因为有延迟槽的存在,跳转类的指令进入ID级时,PCF指向的是延迟槽中的指令,而这一条指令,不管是否跳转都是要执行的,因此对程序没有影响 在这个周期的末尾,我们就可以计算出正确的NPC将其输送到IF级,随着时钟上升沿的到来,PCF指向正确的NPC,而延迟槽的指令也到达了ID级,实现了整个程序的顺利执行
冒险控制的实现
控制信号设计(懒得打表直接贴源码的我是屑):
// 先进行相同地址判断
if ((rs == WAE) && RegWriteE && (WAE != 5'b0)) begin
    if (rs_Tuse < TnewE) begin
        pause = 1;
    end else if (rs_Tuse == 0 && TnewE == 0) begin
        // R1E转发到RD1
        ForwardRD1 = 2'b01;
    end else if (rs_Tuse == 1 && TnewE == 0) begin
        // R1E转发到RD1
        ForwardRD1 = 2'b01;
    end else if (rs_Tuse == 1 && TnewE == 1) begin
        // AOM到ALUA
        ForwardA = 2'b01;
    end
end else if ((rs == WAM) && RegWriteM && (WAM != 5'b0)) begin
    if (rs_Tuse < TnewM) begin
        pause = 1;
    end else if (rs_Tuse == 0 && TnewM == 0) begin
        // AOM到RD1
        ForwardRD1 = 2'b10;
    end else if (rs_Tuse == 1 && TnewM == 0) begin
        // AOM到RD1
        ForwardRD1 = 2'b10;
    end else if (rs_Tuse == 1 && TnewM == 1) begin
        // RWDW到ALUA
        ForwardA = 2'b10;
    end
end
if ((rt == WAE) && RegWriteE && (WAE != 5'b0)) begin
    if (rt_Tuse < TnewE) begin
        pause = 1;
    end else if (rt_Tuse == 0 && TnewE == 0) begin
        // R1E转发到RD2
        ForwardRD2 = 2'b01;
    end else if (rt_Tuse == 1 && TnewE == 0) begin
        // R1E转发到RD2
        ForwardRD2 = 2'b01;
    end else if (rt_Tuse == 1 && TnewE == 1) begin
        // AOM到ALUB
        ForwardB = 2'b01;
    end else if (rt_Tuse == 2 && TnewE == 0) begin
        // R1E转发到RD2
        ForwardRD2 = 2'b01;
    end else if (rt_Tuse == 2 && TnewE == 1) begin
        // AOM到ALUB
        ForwardB = 2'b01;
    end else if (rt_Tuse == 2 && TnewE == 2) begin
        // RWDW到DWD
        ForwardWD = 1;
    end
end else if ((rt == WAM) && RegWriteM && (WAM != 5'b0)) begin
    if (rt_Tuse < TnewM) begin
        pause = 1;
    end else if (rt_Tuse == 0 && TnewM == 0) begin
        // AOM到RD2
        ForwardRD2 = 2'b10;
    end else if (rt_Tuse == 1 && TnewM == 0) begin
        // AOM到RD2
        ForwardRD2 = 2'b10;
    end else if (rt_Tuse == 1 && TnewM == 1) begin
        // RWDW到ALUB
        ForwardB = 2'b10;
    end else if (rt_Tuse == 2 && TnewM == 0) begin
        // AOM到RD2
        ForwardRD2 = 2'b10;
    end else if (rt_Tuse == 2 && TnewM == 1) begin
        // RWDW到ALUB
        ForwardB = 2'b10;
    end
end说明:这里要注意的细节也很多,包括判断时要注意判断RegWrite信号和地址是否为$0,否则可能会把不需要转发的数据转发过去;以及外层的判断逻辑不能使用else if,可能会出现rs,rt均冲突的情况
对各个指令的rs_Tuse,rt_Tuse和TnewD的译码(其它控制信号不再赘述了)
| 指令名 | rs_Tuse | rt_Tuse | TnewD |
|---|---|---|---|
| add | 1 | 1 | 2 |
| sub | 1 | 1 | 2 |
| ori | 1 | - | 2 |
| lw | 1 | - | 3 |
| sw | 1 | 2 | - |
| lui | - | - | 2 |
| beq | 0 | 0 | - |
| jal | - | - | 1 |
| jr | 0 | - | - |
| nop | - | - | - |
至此,控制信号得到了解决,剩下就是复杂重复的的接线了,完成这部分离我们做完流水线cpu就不远了!
接线问题
其实解决了冒险控制的一大难题后,我们CPU的设计便只剩下接线工作了,然接线也有一定的技巧来帮助我们节省时间,这点我深有体会,因此也想谈一谈这个问题
命名规范
我们在命名时,最好使用统一的格式,在流水线的设计时,经常有同名信号在不同级出现的情况,我的做法是在这样的信号后面加上后缀,如一切和EX级相关的信号加上后缀E,而在各级之间的流水线寄存器,实现后缀的转变,如EX/MEM级流水寄存器,我所输入的信号后缀都是E,在输出后把后缀换成M,这样我们的线路就能更清晰,如下:
module EXtoMEM (
    input clk,
    input reset,
    input MemtoRegE,
    input RegWriteE,
    input MemWriteE,
    input [31:0] PCE,
    input [31:0] AOE,
    input [31:0] DWDE,
    input [4:0] WAE,
    input ForwardWDE,
    input [1:0] TnewE,
    output reg MemtoRegM,
    output reg RegWriteM,
    output reg MemWriteM,
    output reg [31:0] PCM,
    output reg [31:0] AOM,
    output reg [31:0] DWDM,
    output reg [4:0] WAM,
    output reg ForwardWDM,
    output reg [1:0] TnewM
);

    initial begin
        MemtoRegM = 0;
        RegWriteM = 0;
        MemWriteM = 0;
        PCM = 32'b0;
        AOM = 32'b0;
        DWDM = 32'b0;
        WAM = 5'b0;
        ForwardWDM = 0;
        TnewM = 2'b11;
    end

    always @(posedge clk) begin
        if (reset) begin
            MemtoRegM <= 0;
            RegWriteM <= 0;
            MemWriteM <= 0;
            PCM <= 32'b0;
            AOM <= 32'b0;
            DWDM <= 32'b0;
            WAM <= 5'b0;
            ForwardWDM <= 0;
            TnewM <= 2'b11;
        end else begin
            MemtoRegM <= MemtoRegE;
            RegWriteM <= RegWriteE;
            MemWriteM <= MemWriteE;
            PCM <= PCE;
            AOM <= AOE;
            DWDM <= DWDE;
            WAM <= WAE;
            ForwardWDM <= ForwardWDE;
            if (TnewE == 2'b0) begin
                TnewM <= 0;
            end else begin
                TnewM <= TnewE - 1;
            end
        end
    end
endmodule
线路设计
在接线时,我们应该要明确每个模块所必需的输入,不要出现把没用的信号传进模块的情况,如某些控制信号以及PC,这些需要流水传递而又暂时用不到的信号可以直接传入下一级流水寄存器,以此来减少我们的线路开销 特别对于ID和WB级的模块,虽然对GRF的读和写在时间上是分开的,但其在空间上却是不可以分离的,此时我们就跟需要特别注意我们的线路设计问题和命名规范
如果能做到清晰的命名规范和线路设计,那我们在连线时甚至可以用和端口同名的wire变量,这大大减少了我们的工作量
以下是我的顶层模块mips
module mips (
    input clk,
    input reset
);
    // ****** IF wire ****** //
    // input
    wire [31:0] NPC;                        // 下次的PC的值
    wire PCsrc;                             // PC选择控制信号
    wire StallPC;                           // PC冻结信号
    // output
    wire [31:0] PCF;                        // 当前PC的值
    wire [31:0] InstrF;                     // 当前指令

    // ****** IFtoID wire ****** //
    // input
    wire StallFtoD;

    // ****** ID wire ****** //
    // input
    wire [31:0] PCD;
    wire [31:0] InstrD;
    wire [31:0] R1E;
    wire [31:0] AOM;
    wire [1:0] ForwardRD1;
    wire [1:0] ForwardRD2;
    // output
    wire MemtoRegD;                         // 传入IDtoEX的MemtoReg
    wire RegWriteD;                         // 传入IDtoEX的RegWrite
    wire MemWriteD;                         // 传入IDtoEX的MemWrite
    wire ALUsrcD;                           // 传入IDtoEX的ALUSrc
    wire [3:0] ALUopD;                      // 传入IDtoEX的ALUop
    wire [31:0] R1D;                        // 传入IDtoEX的ReadData1
    wire [31:0] R2D;                        // 传入IDtoEX的ReadData2
    wire [31:0] Imm32D;                     // 传入IDtoEX的扩展后的Imm32
    wire [4:0] WAD;                         // 传入IDtoEX的WriteAddress
    wire [4:0] rs;                          // rs
    wire [4:0] rt;                          // rt
    wire [1:0] rs_Tuse;
    wire [1:0] rt_Tuse;
    wire [1:0] TnewD;

    // ****** HazardCTRL wire ******//
    wire pause;
    // ****** IDtoEX wire ****** //
    // input
    wire ClearDtoE;
    wire [1:0] ForwardA;
    wire [1:0] ForwardB;
    wire ForwardWD;
    // output
    wire MemtoRegE;
    wire RegWriteE;
    wire MemWriteE;
    wire [31:0] PCE;
    wire [4:0] WAE;
    wire ForwardWDE;
    wire [1:0] TnewE;

    // ****** EX wire ****** //
    // input
    wire ALUsrcE;
    wire [3:0] ALUopE;
    wire [31:0] R2E;
    wire [31:0] Imm32E;
    wire [1:0] ForwardAE;
    wire [1:0] ForwardBE;
    // output
    wire [31:0] AOE;
    wire [31:0] DWDE;

    // ****** EXtoMEM wire ******//
    // output
    wire RegWriteM;
    wire [4:0] WAM;
    wire ForwardWDM;
    wire [1:0] TnewM;

    // ****** MEM wire ****** //
    // input
    wire MemtoRegM;
    wire MemWriteM;
    wire [31:0] PCM;
    wire [31:0] DWDM;
    // output
    wire [31:0] RWDM;

    // ****** WB wire ****** //
    // input
    wire [31:0] PCW;                        // MEMtoWB传入的PC;用于写入GRF时的$display
    wire [31:0] RWDW;                       // MEMtoWB传入的RegWriteData
    wire [4:0] WAW;                         // MEMtoWB传入的WriteAddress
    wire RegWriteW;                         // MEMtoWB传入的RegWrite

    // IF unit
    IF ifu(
        .clk(clk),
        .reset(reset),
        .NPC(NPC),
        .PCsrc(PCsrc),
        .StallPC(StallPC),
        .PCF(PCF),
        .InstrF(InstrF)
    );
    // IFtoID unit
    IFtoID iftoid(
        .clk(clk),
        .reset(reset),
        .StallFtoD(StallFtoD),
        .PCF(PCF),
        .InstrF(InstrF),
        .PCD(PCD),
        .InstrD(InstrD)
    );
    // ID_WB unit
    ID_WB id_wb(
        .clk(clk),
        .reset(reset),
        .PCD(PCD),
        .InstrD(InstrD),
        .PCW(PCW),
        .RWDW(RWDW),
        .WAW(WAW),
        .RegWriteW(RegWriteW),
        .R1E(R1E),
        .AOM(AOM),
        .ForwardRD1(ForwardRD1),
        .ForwardRD2(ForwardRD2),
        .MemtoRegD(MemtoRegD),
        .RegWriteD(RegWriteD),
        .MemWriteD(MemWriteD),
        .ALUsrcD(ALUsrcD),
        .ALUopD(ALUopD),
        .R1D(R1D),
        .R2D(R2D),
        .Imm32D(Imm32D),
        .WAD(WAD),
        .NPC(NPC),
        .PCsrc(PCsrc),
        .rs(rs),
        .rt(rt),
        .rs_Tuse(rs_Tuse),
        .rt_Tuse(rt_Tuse),
        .TnewD(TnewD)
    );
    // Hazard CTRL unit
    HazardCTRL hazardctrl(
        .rs(rs),
        .rt(rt),
        .WAE(WAE),
        .RegWriteE(RegWriteE),
        .WAM(WAM),
        .RegWriteM(RegWriteM),
        .rs_Tuse(rs_Tuse),
        .rt_Tuse(rt_Tuse),
        .TnewE(TnewE),
        .TnewM(TnewM),
        .ForwardRD1(ForwardRD1),
        .ForwardRD2(ForwardRD2),
        .ForwardA(ForwardA),
        .ForwardB(ForwardB),
        .ForwardWD(ForwardWD),
        .pause(pause)
    );
    // PauseCTRL unit
    PauseCTRL pausectrl(
        .pause(pause),
        .StallPC(StallPC),
        .StallFtoD(StallFtoD),
        .ClearDtoE(ClearDtoE)
    );
    // IDtoEX unit
    IDtoEX idtoex(
        .clk(clk),
        .reset(reset),
        .ClearDtoE(ClearDtoE),
        .MemtoRegD(MemtoRegD),
        .RegWriteD(RegWriteD),
        .MemWriteD(MemWriteD),
        .ALUsrcD(ALUsrcD),
        .ALUopD(ALUopD),
        .PCD(PCD),
        .R1D(R1D),
        .R2D(R2D),
        .Imm32D(Imm32D),
        .WAD(WAD),
        .ForwardA(ForwardA),
        .ForwardB(ForwardB),
        .ForwardWD(ForwardWD),
        .TnewD(TnewD),
        .MemtoRegE(MemtoRegE),
        .RegWriteE(RegWriteE),
        .MemWriteE(MemWriteE),
        .ALUsrcE(ALUsrcE),
        .ALUopE(ALUopE),
        .PCE(PCE),
        .R1E(R1E),
        .R2E(R2E),
        .Imm32E(Imm32E),
        .WAE(WAE),
        .ForwardAE(ForwardAE),
        .ForwardBE(ForwardBE),
        .ForwardWDE(ForwardWDE),
        .TnewE(TnewE)
    );
    // EX unit
    EX ex(
        .ALUsrcE(ALUsrcE),
        .ALUopE(ALUopE),
        .R1E(R1E),
        .R2E(R2E),
        .Imm32E(Imm32E),
        .AOM(AOM),
        .RWDW(RWDW),
        .ForwardAE(ForwardAE),
        .ForwardBE(ForwardBE),
        .AOE(AOE),
        .DWDE(DWDE)
    );
    // EXtoMEM unit
    EXtoMEM extomem(
        .clk(clk),
        .reset(reset),
        .MemtoRegE(MemtoRegE),
        .RegWriteE(RegWriteE),
        .MemWriteE(MemWriteE),
        .PCE(PCE),
        .AOE(AOE),
        .DWDE(DWDE),
        .WAE(WAE),
        .ForwardWDE(ForwardWDE),
        .TnewE(TnewE),
        .MemtoRegM(MemtoRegM),
        .RegWriteM(RegWriteM),
        .MemWriteM(MemWriteM),
        .PCM(PCM),
        .AOM(AOM),
        .DWDM(DWDM),
        .WAM(WAM),
        .ForwardWDM(ForwardWDM),
        .TnewM(TnewM)
    );
    // MEM unit
    MEM mem(
        .clk(clk),
        .reset(reset),
        .MemtoRegM(MemtoRegM),
        .MemWriteM(MemWriteM),
        .PCM(PCM),
        .AOM(AOM),
        .DWDM(DWDM),
        .RWDW(RWDW),
        .ForwardWDM(ForwardWDM),
        .RWDM(RWDM)
    );
    // MEMtoWB unit
    MEMtoWB memtowb(
        .clk(clk),
        .reset(reset),
        .PCM(PCM),
        .RWDM(RWDM),
        .WAM(WAM),
        .RegWriteM(RegWriteM),
        .PCW(PCW),
        .RWDW(RWDW),
        .WAW(WAW),
        .RegWriteW(RegWriteW)
    );
endmodule
二.测试方案
测试数据通路
在搭建完流水线CPU的数据通路后,我先简单的测试了一下数据通路能否跑通,这一部分比较简单,随便构造几个不会冲突的数据(或者插入nop)即可 如下:
ori     $t1, $0, 100
ori     $t2, $0, 1000
nop
nop
add     $t3, $t1, $t1
sub     $t4, $t2, $t1
当时数据通路能跑通还是很开心的,然而这距离我真正实现流水线还是有三天的距离
测试冒险控制
实现HazardCtrl后,就可以构造一些会产生冒险的样例进行测试了
如下:
ori     $t1, $0, 100
add     $t2, $t1, $t1
add     $t3, $t2, $t2
add     $t4, $t3, $t3
/******************/
ori     $t1, $0, 100
sw      $t1, 0($0)
lw      $t2, 0($0)
beq     $t1, $t2, label
ori     $s1, $0, 64
label:
add     $t3, $t1, $t2
记得beq指令后要手动添加指令形成延迟槽 这个阶段我还是发现了不少bug,比如rs,rt的同时冲突等 能通过自己的测试还是给了我很大的信心,于是又跑了教程的测例
55000@00003000: $28 <= 00000000
65000@00003004: $29 <= 00000000
75000@00003008: $ 1 <= 00001010
85000@0000300c: $ 2 <= 87230000
95000@00003010: $ 3 <= 00007856
105000@00003014: $ 4 <= 85ff0000
115000@00003018: $ 5 <= 00000001
125000@0000301c: $ 6 <= ffff0000
135000@00003020: $ 7 <= 0000ffff
145000@00003024: $ 1 <= 87231010
155000@00003028: $ 9 <= 87238866
165000@0000302c: $ 8 <= 00001010
175000@00003030: $ 0 <= 0000ffff
225000@0000304c: $ 2 <= 0000000c
265000@0000305c: $31 <= 00003064
265000@00003060: *0000000c <= 87231010
285000@0000306c: $ 1 <= 8723101c
295000@00003070: $ 1 <= 87231028
305000@00003074: $ 1 <= 87231034
305000@00003078: *0000000c <= 00003064
325000@0000307c: $ 1 <= 00003064
365000@00003090: *0000000c <= 00003064
395000@00003068: $ 1 <= 00003070
结果没什么问题,然后提交了一次,还差一个点
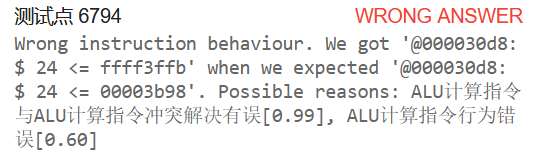
在同学的帮助下de出来是向0号寄存器写入的情况 最终也是完美通关
三.思考题
-
我们使用提前分支判断的方法尽早产生结果来减少因不确定而带来的开销,但实际上这种方法并非总能提高效率,请从流水线冒险的角度思考其原因并给出一个指令序列的例子。 分支判断所需要读取的寄存器可能也会遇到数据冒险问题,如:
lw      $t1, 0($0)
beq     $t1, $0, label
当beq指令进入ID级时,对$t1的改写还未完成,准确来说还没有读出数据,此时需要暂停,所以依旧影响了效率
-
因为延迟槽的存在,对于 jal 等需要将指令地址写入寄存器的指令,要写回 PC + 8,请思考为什么这样设计? 延迟槽的设计使得所有跳转类指令后都会紧跟一条不影响程序执行的指令,所以逻辑上jal指令后要执行的应该是延迟槽后的指令,所以要写PC+8
-
我们要求所有转发数据都来源于流水寄存器而不能是功能部件(如 DM、ALU),请思考为什么? 在实际电路中,组合逻辑也有一定的延迟,从功能部件的输出端转发实际上是把两个组合逻辑连在了一起,这大大增加了我们的时间开销,不利于提高效率
-
我们为什么要使用 GPR 内部转发?该如何实现? 在指令的执行过程中,我们可能会遇到在同一周期读写同一个寄存器的情况,这就需要我们进行GRF的内部转发来解决这一情况 当写入和读取的地址相同时,我们可以通过把写入数据转发到读取数据的方式实现内部转发(PS:我用的是下降沿写入所以没设计内部的转发)
-
我们转发时数据的需求者和供给者可能来源于哪些位置?共有哪些转发数据通路? 本人设计的全部转发线路(按流水级顺序)
R1E到RD1,RD2AOM到ALUA,ALUB,RD1,RD2RWDW到ALUA,ALUB,DWD
注:R1E是ReadData1E,AOM是ALUresultM,RWDW是RegisterWriteDataW,DWD是DMWriteData
-
在课上测试时,我们需要你现场实现新的指令,对于这些新的指令,你可能需要在原有的数据通路上做哪些扩展或修改?提示:你可以对指令进行分类,思考每一类指令可能修改或扩展哪些位置。 首先需要对新指令进行译码,在CTRL模块增加新信号的输出,如果该信号依旧满足原有的冒险控制模型,则几乎不需要增加新的信号,具体情况要依照信号的具体内容再作设计
-
简要描述你的译码器架构,并思考该架构的优势以及不足。 我使用的是指令驱动型:整体在一个 case 语句之下,通过判断指令的类型,对所有的控制信号一一赋值。 这种方法便于指令的添加,不易遗漏控制信号,但是整体代码量会随指令数量增多而显著增大。
DISCUSSION
コメント